Agenci AI potykają się o dane, nie o modele. Co to oznacza dla sektorów regulowanych
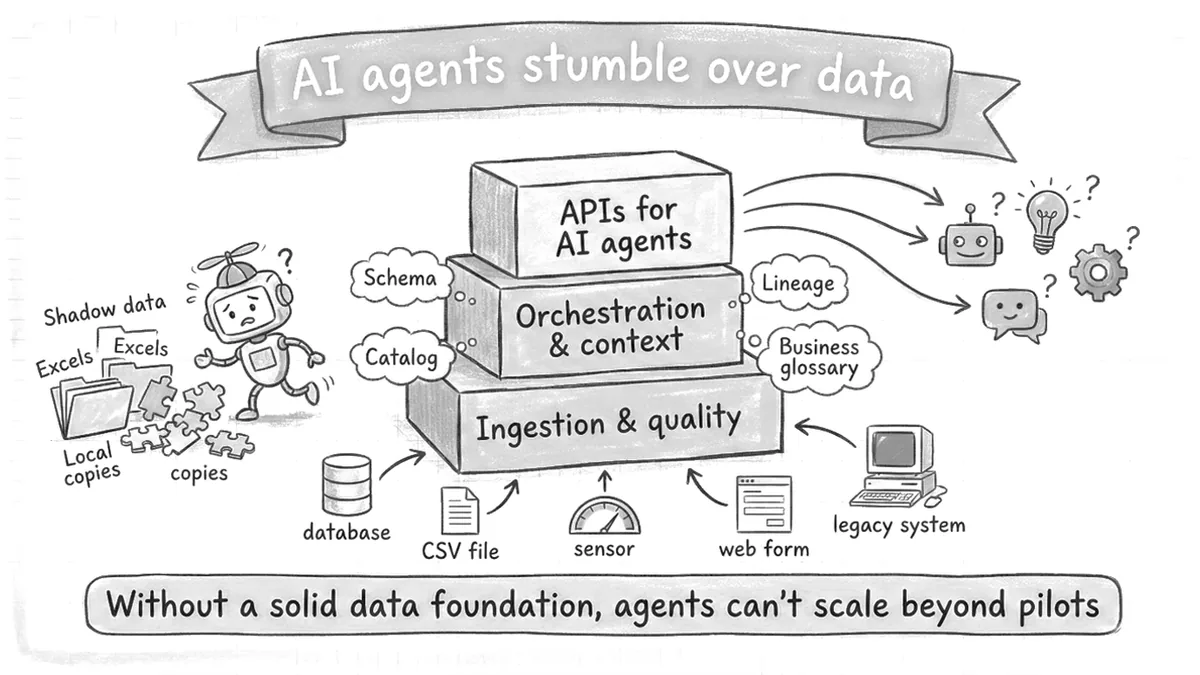
Obecnie niemal dwie trzecie firm eksperymentuje z agentami AI, ale mniej niż jedna dziesiąta skaluje ich wykorzystanie do poziomu, na którym przynoszą mierzalną wartość biznesową. W rozmowach z zespołami wdrożeniowymi — w bankowości, ubezpieczeniach, administracji i energetyce — przyczyna niemal zawsze jest taka sama. Nie chodzi o model. Nie chodzi o framework agentowy. Chodzi o fundament danych: silosy, niespójne definicje, nieszczelną kontrolę jakości oraz nadzór istniejący w politykach, lecz nie w systemie.
W erze „generatywna AI + czat” ten fundament można było jeszcze ukryć. Między modelem a decyzją znajdował się człowiek: dopracowywał polecenie, filtrował wynik, ignorował halucynację. W erze agentów — czyli podmiotów, które samodzielnie uzyskują dostęp do systemów, wywołują narzędzia, zapisują dane w bazach i komunikują się ze sobą — ten bufor znika. Jeżeli dane są rozproszone, agent będzie:
- podejmował różne decyzje w zależności od tego, z którego silosu akurat odczytuje dane,
- tracił kontekst między kanałami (ten sam klient ma trzy różne „prawdy” w trzech systemach),
- propagował błędy w łańcuchu przepływu pracy szybciej, niż człowiek zdoła je zauważyć.
W pewnym momencie „ręczne naprawianie” staje się niemożliwe. Fundament trzeba poprawić — w przeciwnym razie każdy kolejny agent będzie pogłębiał problem, zamiast go rozwiązywać.
Fundament danych dla agentów AI
Fundament danych jako operacyjny rdzeń wiedzy agenta
Agentowa AI to nie tylko „model i trochę kodu spajającego”. To układ nerwowy zbudowany z danych, do których agent ma stały, operacyjny dostęp. Aby taki system działał, kilka warunków musi zostać spełnionych jednocześnie:
- architektura danych wspiera autonomię i decyzje w czasie rzeczywistym — nie tylko raportowanie z opóźnieniem,
- warstwy danych są modułowe i spójne semantycznie — agent widzi jeden obraz świata niezależnie od systemu, z którego czyta,
- nadzór jest wbudowany w sam przepływ danych, a nie dodawany po fakcie — ponieważ nikt nie zdoła ręcznie ocenić każdej decyzji, gdy agentów jest tysiąc, a nie jeden.
W metodyce CDF (Cognitive Deployment Framework), którą rozwijam jako podejście do wdrażania AI w sektorach regulowanych, nazywam ten element operacyjnym rdzeniem wiedzy agenta. Funkcjonalnie składa się on z kilku warstw, które muszą się ze sobą komunikować: pamięci operacyjnej łączącej bazę wektorową, dziedzinowy graf wiedzy i kontekst dialogu z pełnym pochodzeniem danych; warstwy semantycznej (ontologie, definicje, relacje); potoku wyszukiwania, w którym każdą odpowiedź można uzasadnić po fakcie; oraz bramy kontrolującej dostęp agenta do danych i narzędzi. Dokładnie taki zestaw warstw buduję we własnym stosie produkcyjnym.
W sektorach regulowanych to nie „architektura” — to zgodność
W tym miejscu trzeba wspomnieć o czymś, o czym standardowe publikacje branżowe rzadko mówią, choć ma to absolutnie kluczowe znaczenie dla każdego, kto wdraża agentów w banku, firmie ubezpieczeniowej, urzędzie, szpitalu lub infrastrukturze krytycznej.
Fundament danych dla agentów w sektorze regulowanym nie jest wyłącznie decyzją architektoniczną. To element zgodności. Cztery regulacje unijne, które właśnie weszły lub wkrótce wejdą w życie, na nowo definiują wymagania wobec tej warstwy:
- DORA (Digital Operational Resilience Act) wymaga od instytucji finansowych odtwarzalności operacyjnej i zgłaszania incydentów. W praktyce oznacza to, że każdą decyzję agenta trzeba móc odtworzyć po fakcie: jakich danych użyto, w której wersji, z jakiego źródła i z jakim poziomem pewności.
- Unijny akt w sprawie AI wymaga w przypadku systemów wysokiego ryzyka (ocena zdolności kredytowej, HR, infrastruktura krytyczna, administracja) audytu, rejestrowania zdarzeń i nadzoru człowieka. Oznacza to, że fundament danych musi zachowywać pełne pochodzenie każdego rekordu wykorzystywanego przez agenta.
- NIS2 wymaga ścisłej kontroli dostępu i zdolności reagowania na incydenty w podmiotach kluczowych i ważnych. Oznacza to, że dostęp agenta do danych musi podlegać rygorystycznej kontroli RBAC, z rejestrowaniem każdej operacji odczytu i eskalacją naruszeń.
- ISO/IEC 42001 (system zarządzania AI) wymaga udokumentowanych procesów zarządzania cyklem życia systemów AI, w tym ich danymi wejściowymi i wyjściowymi.
Połączenie tych czterech wymagań oznacza jedno: nadzoru nad agentami w sektorze regulowanym nie można zbudować jako warstwy dodanej nad platformą danych. Musi być wbudowany w sam przepływ pracy. W praktyce realizuję to jako wielopoziomową bramę suwerenności działającą w trybie fail-closed: agent nie uzyska dostępu do danych, do których nie ma uprawnień, nawet jeżeli polecenie próbuje go do tego zmusić; każdy dostęp jest rejestrowany; dane osobowe są wykrywane i maskowane, zanim opuszczą warstwę wyszukiwania, zgodnie z branżowymi standardami wykrywania PII.
Tej części żaden uniwersalny framework agentowy nie zapewnia od razu — trzeba ją zaprojektować dla konkretnego sektora, przepisów i rzeczywistych wymagań audytowalności. Właśnie wtedy fundament danych przestaje być tematem rozmowy z zespołem inżynierii danych, a staje się tematem rozmowy z CISO, specjalistą compliance i zewnętrznym audytorem.
Siedem cech fundamentu, który naprawdę wytrzyma działanie agentów
Dobry operacyjny rdzeń wiedzy — niezależnie od tego, jak go nazwiemy — musi mieć siedem cech. To nie są chwilowe mody. Brak każdej z nich niezmiennie powraca jako problem na produkcji.
- Ingestia jako produkt. Każdy typ danych — wsadowe, czasu rzeczywistego, ustrukturyzowane, nieustrukturyzowane — ma powtarzalną, wersjonowaną i monitorowaną ścieżkę ingestii. Nie ma „doraźnych importów”, które działają, ale nikt nie wie dlaczego.
- Znaczenie, a nie tylko dane. Wspólne definicje, słowniki, semantyka i ontologia dziedzinowa. Agent musi wiedzieć, że „klient” w CRM to ten sam podmiot co „kontrahent” w systemie płatniczym. Bez tej warstwy każdy agent na nowo wynajduje koło — i każdy robi to inaczej.
- Jeden fundament dla analityki i AI. Zamiast budować osobne potoki danych „do raportów” i „do modeli”, dane wytwarza się raz i wykorzystuje wszędzie. Jest to tańsze, ale przede wszystkim spójniejsze — ponieważ agent i pulpit widzą tę samą prawdę.
- Zaufanie wbudowane w platformę. Bezpieczeństwo, kontrola dostępu, prywatność i klasyfikacja danych są zautomatyzowane, a nie wykonywane ręcznie dla każdego projektu. W sektorach regulowanych to warunek przejścia audytu.
- Stabilne interfejsy do modeli i danych. Jasne API, punkty dostępu i kontrakty. Zespoły budujące agentów nie powinny za każdym razem „przecierać nowych szlaków” integracji.
- Widoczność i mierzalność. Ciągłe wskaźniki jakości danych, wydajności modelu, kosztu inferencji, opóźnień i błędów. Bez nich fundament degraduje się niezauważalnie — aż do dnia, w którym agent podejmie decyzję na podstawie danych, których nikt już nie utrzymuje.
- Kontrolowana warstwa wykonywania agentów. Wspólne środowisko wykonawcze, które koordynuje agentów, egzekwuje polityki organizacji i służy jako brama do danych oraz modeli. Szczegóły techniczne mogą różnić się między wdrożeniami — liczy się sama zasada: agenci nigdy nie działają „luzem”.
Bez tych siedmiu cech każdy duży projekt agentowy prędzej czy później uderzy w ścianę — tylko za każdym razem w innym miejscu.
Dwa archetypy agentowych przepływów pracy i ich wymagania wobec danych
W praktyce widzę dwa dominujące wzorce.
Jednoagentowy — jeden agent kolejno wykorzystuje wiele narzędzi i źródeł danych, aby zrealizować proces od początku do końca. Największym ryzykiem są tu niespójne decyzje wynikające z fragmentacji danych — agent „widzi” różne wersje prawdy w różnych systemach i nie jest tego świadomy.
Wieloagentowy — grupa wyspecjalizowanych agentów współpracuje, udostępniając kontekst za pośrednictwem wspólnego grafu wiedzy i precyzyjnie kontrolowanego dostępu do danych. Ryzyko ma tu inny charakter: jest nim utrata koordynacji i kaskadowe błędy między agentami, jeżeli brakuje wspólnej semantyki i ścisłych reguł dostępu. Z moich wdrożeń jasno wynika, że przejście od jednego do wielu agentów jest momentem, w którym organizacje najczęściej zderzają się ze ścianą fundamentu danych — jeden agent wiele wybaczał, wielu agentów nie wybacza niczego.
W obu przypadkach rozwiązanie jest takie samo: spójny rdzeń semantyczny i rygorystycznie egzekwowane reguły dostępu. Różni się tylko moment, w którym organizacja to odkrywa.
Zanim przejdę do konkretów, warto od razu obalić jedno nieporozumienie. Siedem wymienionych wcześniej cech nie oznacza, że przed uruchomieniem pierwszego agenta trzeba uporządkować wszystkie dane w organizacji. Wręcz przeciwnie. Strategia „najpierw posprzątajmy całą firmę, a potem wprowadźmy AI” prowadzi do paraliżu — tego samego, który w ostatnich dwóch dekadach zatrzymał większość inicjatyw Master Data Management i Data Lake. Cechy fundamentu buduje się przyrostowo, w konkretnym przepływie pracy, w którym uruchamia się pierwszy pilotaż. Ten przepływ staje się poligonem dla całej platformy. Dopiero kolejne przepływy rozszerzają zakres. Ci, którzy czekają na „gotowy fundament”, nigdy nie zaczną. Ci, którzy zaczynają od konkretnego procesu o mierzalnej stawce biznesowej, budują fundament po drodze — taniej, szybciej i z większą szansą, że rozwiązanie przetrwa pierwszy rok.
Cztery kroki przygotowania danych dla agentów
1. Wybierz przepływy pracy, które naprawdę warto „zagentować”
Zamiast robić „po trochu wszystkiego”, lepiej zacząć od dwóch lub trzech procesów realizowanych od początku do końca, w których większa autonomia przyniesie namacalną różnicę biznesową (underwriting, obsługa klienta, zarządzanie wiedzą, monitoring zgodności). Każdy pilotaż musi mieć jasne wskaźniki i od początku uwzględniać możliwość ponownego użycia komponentów — nie budujemy zabawki.
2. Modernizuj warstwy fundamentu ewolucyjnie, nie rewolucyjnie
Nie chodzi o wyrzucenie wszystkiego. Chodzi o wzmocnienie kluczowych warstw: źródeł, platform, semantyki, produktów danych i warstwy konsumpcji. W sektorze regulowanym dochodzą do tego brama suwerenności i warstwa pochodzenia danych — nie jest to opcja, lecz warunek wejścia.
3. Przejdź od „sporadycznego czyszczenia” do ciągłej jakości danych
Jednorazowe „posprzątanie tabeli przed projektem” nie wystarczy. Potrzebne są ciągły monitoring jakości, automatyczne walidacje, wykrywanie anomalii i wzbogacanie danych z użyciem samych modeli AI. W ramach CDF rozwijam wielowarstwowy system obrony przed halucynacjami, w którym każda warstwa ma inne zadanie, ale razem tworzą rygorystyczny reżim kontroli jakości danych, który niczego nie pomija. Dane generowane przez samych agentów także muszą spełniać ten sam standard — nie mogą być „ciemną materią” organizacji.
4. Zbuduj operacyjny model zarządzania agentami
To nie jest już projekt IT — to zmiana sposobu pracy. Potrzebne są spisane reguły (co agent może robić, do jakich danych ma dostęp, kiedy wymagana jest zgoda człowieka), automatyczne egzekwowanie tych reguł w systemie, wyspecjalizowani agenci ochronni monitorujący wyniki innych agentów oraz pełny cykl życia agenta: nadanie tożsamości, logowanie, monitoring i wycofanie. W mojej praktyce model ten jest skodyfikowany w kontrakcie, który nazywam AI-Operating & Working Agreement — federacyjnym porozumieniu między zespołem centralnym (platforma, polityki, nadzór) a domenami biznesowymi odpowiedzialnymi za codzienne działanie agentów w ich przepływach pracy.
Dlaczego warto rozmawiać o tym teraz
W erze agentowej AI sukces odniosą nie firmy z „największym modelem”. Odniosą go te, które:
- konsekwentnie agentują kolejne przepływy pracy na mocnym fundamencie danych,
- mają architekturę pozwalającą agentom pracować na wspólnym obrazie rzeczywistości,
- traktują jakość danych, nadzór i suwerenność jako podstawowe zdolności, a nie dodatek do projektu.
W sektorach regulowanych dochodzi jeszcze jeden wymiar: warstwa zgodności przestaje być ciężarem i staje się fosą ochronną. Kto potrafi zbudować fundament jednocześnie zgodny z DORA, unijnym aktem w sprawie AI i NIS2 oraz obsługujący agentów niemal w czasie rzeczywistym, zyskuje przewagę, której nie da się szybko skopiować.
Mikrowzorzec z praktyki
Każdy dokument w firmowym repozytorium — PDF, Word, e-mail, raport — może mieć automatycznie wygenerowane „pole podsumowania”: trzy kluczowe punkty, najważniejsze liczby, poziom pewności i źródła. Takie podsumowanie, tworzone lokalnie przez mniejszy model w warstwie wzbogacania danych, radykalnie zwiększa skuteczność agentów w warstwie konsumpcji — ponieważ agent pobierający dokument otrzymuje jego istotę jako pierwszy kontekst, zanim jeszcze zacznie czytać szczegóły. Ograniczenie chaosu kontekstowego następuje przed wyszukiwaniem, a nie po nim. To jeden z tych mikrowzorców, których braku w architekturze danych nie widać podczas demonstracji, ale który staje się dramatycznie odczuwalny, gdy zamiast jednego agenta działa ich tysiąc.
Ta seria przedstawia transformację AI w sektorach regulowanych w podziale na siedem warstw:
- Infrastruktura fizyczna — AI pochłania energię elektryczną i światłowody
- Modernizacja systemów legacy — stare systemy nie umrą same
- Fundament danych — agenci AI potykają się o dane ← właśnie to czytasz
- Suwerenność: diagnoza — masz suwerenność danych, ale nie masz suwerennej AI
- Suwerenność: praktyka — suwerenna AI w praktyce
- Interfejs człowiek–system — od chatbota do współpracownika
- Zaufanie i przywództwo — zaufanie jako waluta skalowania AI
Cała seria jest zapisem tego, czego nauczyła mnie praca w sektorach regulowanych — decyzji, które trzeba było podejmować szybciej, niż pozwalała ostrożność, błędów, które nauczyły mnie więcej niż sukcesy, intuicji wyostrzonej w rozmowach bez scenariusza i woli zbudowania czegoś, co jeszcze nie istnieje.