Cognitive SLA: dlaczego dostępność na poziomie 99,9% nie wystarcza, gdy AI wspiera decyzje w firmie
Seria: CDF w praktyce — 6 artykułów o metodyce wdrażania suwerennej AI
*To pierwszy z 6 artykułów o metodyce CDF 1.3.2 — frameworku wdrażania suwerennej AI dla sektorów regulowanych, opracowanym przez allclouds.pl. Cykl SAVANT koncentruje się na zgodności, pomiarze jakości i nadzorze. Cykl GENESIS dotyczy zarządzania agentami, skalowania i operacji. CDF 1.3.2 jest autorską metodyką opracowaną przez allclouds.pl, opartą na ISO/IEC 42001:2023 i unijnym AI Act.*

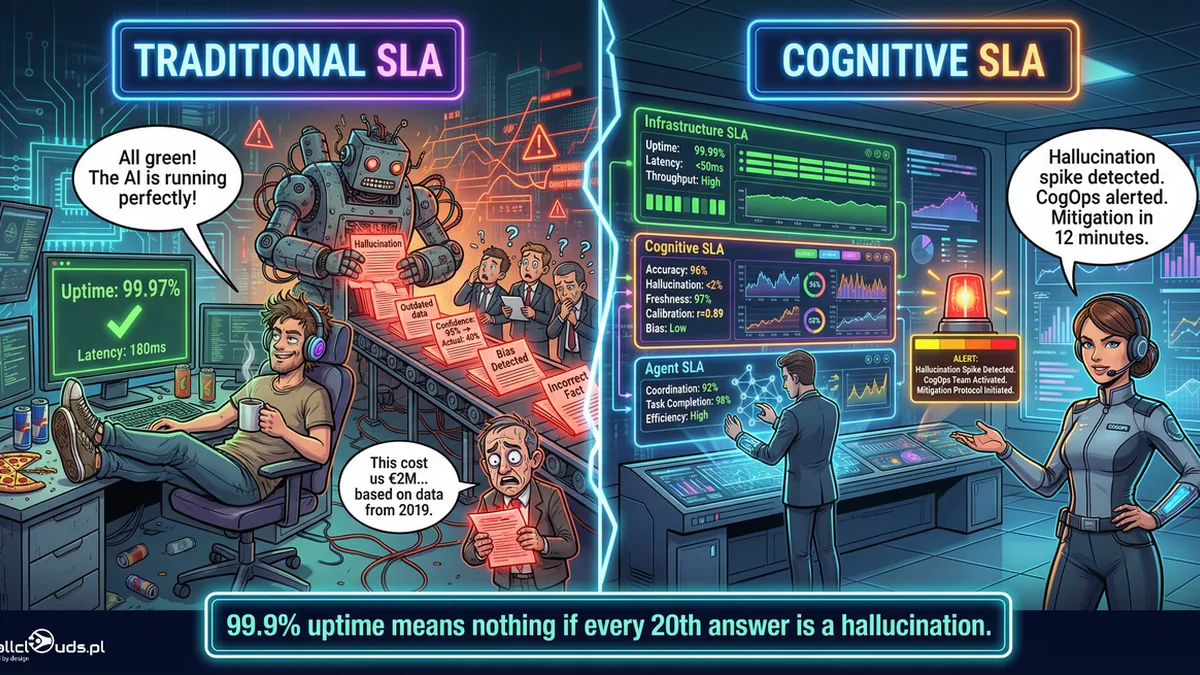
System AI działa nieprzerwanie od trzech miesięcy. Monitoring infrastruktury świeci na zielono: dostępność 99,97%, opóźnienie poniżej 200 milisekund, brak awarii. A jednak co dwudziesta odpowiedź w procesie obsługi klienta opiera się na informacji, której nie da się potwierdzić w żadnym źródle.
Z perspektywy tradycyjnego SLA system jest zdrowy. Z perspektywy organizacji podejmującej decyzje na podstawie tych odpowiedzi system generuje ryzyko — prawne, finansowe i reputacyjne. Właśnie ta luka między „działa” a „działa poprawnie” jest powodem, dla którego CDF 1.3.2 wprowadza pojęcie Cognitive SLA.
Gdzie kończy się klasyczne SLA
Tradycyjne metryki IT — dostępność, opóźnienie i przepustowość — powstały w świecie, w którym systemy miały być dostępne i szybkie. Jeśli serwer odpowiada, usługa działa. To rozsądne założenie dla baz danych, aplikacji webowych czy systemów ERP.
Systemy kognitywne działają jednak inaczej. Model językowy lub agent AI może być dostępny, szybki i stabilny, a jednocześnie halucynować, polegać na nieaktualnej wiedzy, błędnie kalibrować pewność odpowiedzi lub podejmować sprzeczne działania w środowisku wieloagentowym. Żaden z tych problemów nie pojawi się na klasycznym dashboardzie infrastruktury, ponieważ klasyczne metryki po prostu nie mierzą jakości rozumowania.
Dodatek B do metodyki CDF 1.3.2 ujmuje to bez ogródek: tradycyjne metryki IT SLA są konieczne, ale niewystarczające dla systemów kognitywnych. Trudno się z tym nie zgodzić, gdy weźmie się pod uwagę, że systemy LLM i agentowe są z natury probabilistyczne — ich odpowiedzi nigdy nie będą w pełni deterministyczne.
Trzy warstwy, nie jedna
CDF 1.3.2 nie odrzuca klasycznego SLA. Rozszerza je o dwie dodatkowe warstwy, tworząc model trójpoziomowy.
:::table-wrap
| Warstwa | Co mierzy | Kto odpowiada | | --- | --- | --- | | Infrastructure SLA | Dostępność ≥99,9%, opóźnienie ≤200 ms, przepustowość | DevOps / Platform Team | | Cognitive SLA | Reasoning Accuracy, Hallucination Rate, Knowledge Freshness, Confidence Calibration | CogOps / Knowledge Curator | | Agent SLA | Coordination Effectiveness, Task Success Rate, Recovery Rate, Token Budget Compliance | Agent Lifecycle Engineer |
To rozróżnienie ma ważne konsekwencje organizacyjne. Warstwa infrastruktury pozostaje w gestii zespołu platformowego, lecz odpowiedzialność za jakość rozumowania i koordynację agentów przechodzi na nowe role: zespół CogOps, kuratora wiedzy i inżyniera cyklu życia agentów. Innymi słowy, Cognitive SLA zmienia nie tylko to, co mierzymy, ale także to, kto za to odpowiada.
*Szczegółowo opisujemy zarządzanie agentami, których jakość mierzy Agent SLA, w artykule „Agent Governance — jak zarządzać rojem 50 agentów AI bez utraty kontroli”.*
Pięć poziomów autonomii agenta
Zakres i rygor Cognitive SLA zależą bezpośrednio od tego, jak dużą autonomię mają agenci w systemie. CDF 1.3.2 definiuje pięć poziomów autonomii — od L0 do L4 — które określają wymagany zakres monitorowania, częstotliwość audytu i dopuszczalne progi eskalacji.
:::table-wrap
| Poziom | Nazwa | Opis | | --- | --- | --- | | L0 | Human-only | Brak agenta AI; człowiek samodzielnie wykonuje całe zadanie. | | L1 | Human-in-the-loop | Agent przygotowuje rekomendacje, a człowiek zatwierdza każde działanie przed jego wykonaniem. | | L2 | Human-on-the-loop | Agent działa samodzielnie, człowiek nadzoruje i może interweniować. | | L3 | Supervised autonomy | Agent działa autonomicznie, z okresowym audytem i monitorowaniem wydajności. | | L4 | Full autonomy | Pełna autonomia agenta; dozwolona wyłącznie dla procesów niekrytycznych. |
Im wyższy poziom autonomii, tym ważniejsze stają się metryki Cognitive SLA i Agent SLA. Na poziomie L1 kluczowa jest Confidence Calibration — ponieważ człowiek musi ocenić, czy rekomendacji można zaufać. Na poziomach L2–L3 rośnie znaczenie Agent Coordination i automatycznych procedur eskalacji. Poziom L4 wymaga pełnej automatyzacji monitorowania, ponieważ człowiek nie uczestniczy w bieżącym procesie decyzyjnym.
*Poziom autonomii jest jednym z dziewięciu obowiązkowych pól Agent Registry — centralnego rejestru agentów w CDF. Pełny model zarządzania agentami, w tym wzorce interakcji i procedury awaryjne, opisujemy w artykule „Agent Governance — jak zarządzać rojem 50 agentów AI bez utraty kontroli”.*
Siedem metryk definiujących jakość systemu AI
W Fazie 4 CDF — czyli w momencie wdrożenia produkcyjnego — zaczynają obowiązywać konkretne metryki Cognitive SLA. Każda ma zdefiniowany cel, metodę pomiaru i przypisany poziom odpowiedzialności.
:::table-wrap
| Metryka | Co mierzy | Cel | Metoda pomiaru | | --- | --- | --- | --- | | System Availability | Dostępność platformy bazowej | 99,9 | Monitoring infrastruktury (Prometheus, Datadog) | | Reasoning Accuracy Rate | Odsetek odpowiedzi zgodnych z ground truth | ≥95% — procesy krytyczne; ≥90% — standardowe | Ewaluacja względem golden dataset + próbkowy przegląd człowieka | | Hallucination Rate | Odsetek odpowiedzi niepotwierdzonych w źródłach | ≤2% — procesy krytyczne; ≤5% — standardowe | Automatyczna weryfikacja względem bazy wiedzy + audyt losowy | | Mitigation Response Time | Czas od wykrycia błędu kognitywnego do jego korekty | ≤15 min — procesy krytyczne; ≤4 h — standardowe | Znaczniki czasu alertów i zamknięć incydentów | | Knowledge Freshness Index | Świeżość bazy wiedzy w określonym oknie | ≥95% w oknie 7-dniowym | Porównanie dat aktualizacji dokumentów z oknem czasowym | | Agent Coordination | Odsetek zadań wieloagentowych zakończonych bez eskalacji | ≥85% | Logowanie orkiestracji agentów (Immutable Audit Trail) | | Confidence Calibration | Korelacja deklarowanej pewności z rzeczywistą trafnością | r ≥ 0,85 | Analiza statystyczna: deklarowana pewność wobec rzeczywistej trafności |
Warto zwrócić uwagę na dwie rzeczy. Po pierwsze, metryki rozróżniają procesy krytyczne i standardowe, co oznacza, że tolerancja błędu zależy od kontekstu biznesowego, a nie jest jednolita w całym systemie. Po drugie, system mierzy nie tylko trafność odpowiedzi, lecz również szybkość reakcji organizacji na wykryty błąd — Mitigation Response Time ≤15 minut dla procesów krytycznych to bardzo ambitny cel, który wymusza automatyzację wykrywania i procedur naprawczych.
Confidence Calibration — metryka, o której mówi niewiele osób
Spośród siedmiu wskaźników Cognitive SLA jeden zasługuje na osobne omówienie, ponieważ rzadko występuje w praktyce rynkowej: Confidence Calibration.
Odpowiada na pytanie: czy model deklarujący 90% pewności rzeczywiście ma rację w 90% przypadków? Jeśli nie — jeśli model sygnalizuje wysoką pewność, lecz w rzeczywistości myli się znacznie częściej — użytkownik traci możliwość sensownej oceny odpowiedzi. Nie wie, kiedy zaufać rekomendacji, a kiedy ją zweryfikować.
CDF mierzy to za pomocą statystycznej korelacji między deklarowaną pewnością a rzeczywistą trafnością, z celem r ≥ 0,85. To nie jest metryka akademicka — bezpośrednio wpływa na zdolność osób nadzorujących AI do trafnego rozstrzygania, kiedy zaufać systemowi, a kiedy szukać dodatkowego potwierdzenia.
*Confidence Calibration jest bezpośrednio związana z jakością nadzoru człowieka. W artykule „Human Competence Gate” opisujemy mechanizm sprawdzający, czy osoba zatwierdzająca rekomendację AI rzeczywiście rozumie, co zatwierdza — oraz jak kalibracja pewności modelu wpływa na tę zdolność.*
Co się dzieje, gdy metryka spada
Same cele liczbowe nie wystarczą. Równie ważne jest to, co organizacja robi, gdy cel nie zostaje osiągnięty. Dlatego CDF definiuje trzystopniową procedurę eskalacji.
Yellow — metryka pozostaje poniżej celu przez 24 godziny. Automatyczny alert trafia do zespołu CogOps. To sygnał wczesnego ostrzegania: dzieje się coś, co wymaga obserwacji, być może korekty konfiguracji lub odświeżenia bazy wiedzy.
Orange — metryka pozostaje poniżej celu przez 72 godziny. Następuje eskalacja na poziom zarządzania architekturą i obowiązkowa analiza przyczyny źródłowej. To już nie przejściowy spadek, lecz systematyczny problem wymagający zrozumienia przyczyny.
Red — metryka pozostaje poniżej celu przez 7 dni albo Hallucination Rate przekracza 5% w procesie krytycznym. Konsekwencje są poważne: aktywacja Agent Kill-Switch, powiadomienie kierownictwa wykonawczego i wdrożenie planu naprawczego w ciągu 48 godzin.
Procedura jest ważna z dwóch powodów. Po pierwsze, zmienia ogólne odczucie, że „coś nie działa”, w zdefiniowany protokół z przypisanymi rolami, eskalacją i czasem reakcji. Po drugie, łączy Cognitive SLA z Agent Governance — poziom Red może bezpośrednio uruchomić Kill-Switch, czyli fizyczne lub programowe wyłączenie agenta albo całego roju agentów, z kaskadowym powiadamianiem zależnych węzłów.
*CDF definiuje trzy typy Kill-Switch: Single Agent, Swarm i Cognitive Circuit Breaker. Ich pełny opis wraz z Agent Governance Model znajduje się w artykule „Agent Governance — jak zarządzać rojem 50 agentów AI bez utraty kontroli”.*
Cognitive Quality Reports — ciągły dowód, nie jednorazowy test
Metryki Cognitive SLA nie są mierzone raz, a następnie odkładane na półkę. CDF przewiduje comiesięczne Cognitive Quality Reports prezentujące wyniki metryk, trendy jakości rozumowania, incydenty kognitywne i rekomendacje optymalizacyjne.
Ma to znaczenie z perspektywy zarządzania i zgodności. Organizacja nie musi polegać na deklaracji dostawcy, że „system działa dobrze”. Otrzymuje cykliczny, audytowalny raport pokazujący konkretne liczby: jak trafne było rozumowanie, ile wykryto halucynacji, jak szybko reagowano na incydenty i czy baza wiedzy była aktualna.
W środowiskach regulowanych — finansach, administracji publicznej, energetyce i obronności — taki raport nie jest luksusem, lecz koniecznością. Regulatorzy coraz częściej pytają nie o to, czy AI została wdrożona, ale o to, jak organizacja mierzy jej jakość i zarządza nią w czasie.
*Comiesięczne Cognitive Quality Reports są częścią fazy CogOps — ciągłej usługi utrzymaniowej, opisanej szczegółowo w artykule „Cognitive Operations — co dzieje się po wdrożeniu, gdy większość dostawców AI dawno już opuściła firmę”.*
Dlaczego zmienia to rozmowę z dostawcą AI
Większość umów na wdrożenie AI zawiera SLA infrastruktury: dostępność, czas reakcji wsparcia i okna serwisowe. Jest to konieczne, ale niewystarczające, ponieważ cały opis jakości skupia się na warstwie technicznej.
Cognitive SLA przenosi rozmowę na wyższy poziom. Zamiast pytać: „Czy system będzie dostępny?”, organizacja może zapytać: „Jaki odsetek odpowiedzi będzie zgodny z naszą bazą wiedzy?”, „Jak szybko zareagujecie na wykrycie halucynacji w procesie krytycznym?” oraz „Kto konkretnie odpowiada za jakość rozumowania, a kto za koordynację agentów?”.
To pytania, na które wielu dostawców nie ma dziś dobrych odpowiedzi. Nie dlatego, że są nieuczciwi, ale dlatego, że rynek wdrożeń AI nadal działa w kategoriach infrastruktury i nie wypracował powszechnie przyjętych standardów jakości rozumowania.
Kilka pytań, które warto zadać
Przed podpisaniem umowy na wdrożenie lub utrzymanie systemu AI warto sprawdzić:
- Czy dostawca mierzy jakość rozumowania, czy tylko dostępność platformy?
- Czy istnieją odrębne metryki dla procesów krytycznych i standardowych?
- Jaka jest procedura, gdy Hallucination Rate przekroczy ustalony próg?
- Czy organizacja otrzymuje regularne raporty jakości kognitywnej z konkretnymi liczbami?
- Kto po stronie dostawcy odpowiada za jakość rozumowania — DevOps, data science czy dedykowany zespół CogOps?
- Czy istnieje awaryjny mechanizm zatrzymania agenta, jeśli metryki trwale spadną poniżej celu?
Jeśli odpowiedzi na te pytania są niejasne lub sprowadzają się do ogólnego „monitorujemy system”, najprawdopodobniej mówimy o klasycznym SLA infrastruktury bez warstwy kognitywnej. Może to wystarczyć dla prostych narzędzi wsparcia. W przypadku systemu uczestniczącego w procesach biznesowych i wspierającego rzeczywiste decyzje zwykle nie wystarcza.
Cognitive SLA nie zastępuje tradycyjnych metryk IT. Uzupełnia je o to, co w systemach AI jest najważniejsze i najtrudniejsze do zmierzenia: jakość rozumowania, szybkość reakcji na błędy i zdolność utrzymania tej jakości w czasie.
W następnym artykule pokażemy, jak CDF eliminuje Pilot Purgatory i definiuje drogę od pilota do produkcji w 90 dni — z exit criteria, Production Cost Model i Scale Path Definition, które zapewniają, że prototyp nie pozostanie prototypem na zawsze.