Grawitacja danych i ryzyka chmurowe: dlaczego krytyczne decyzje powinny pozostać on-premise
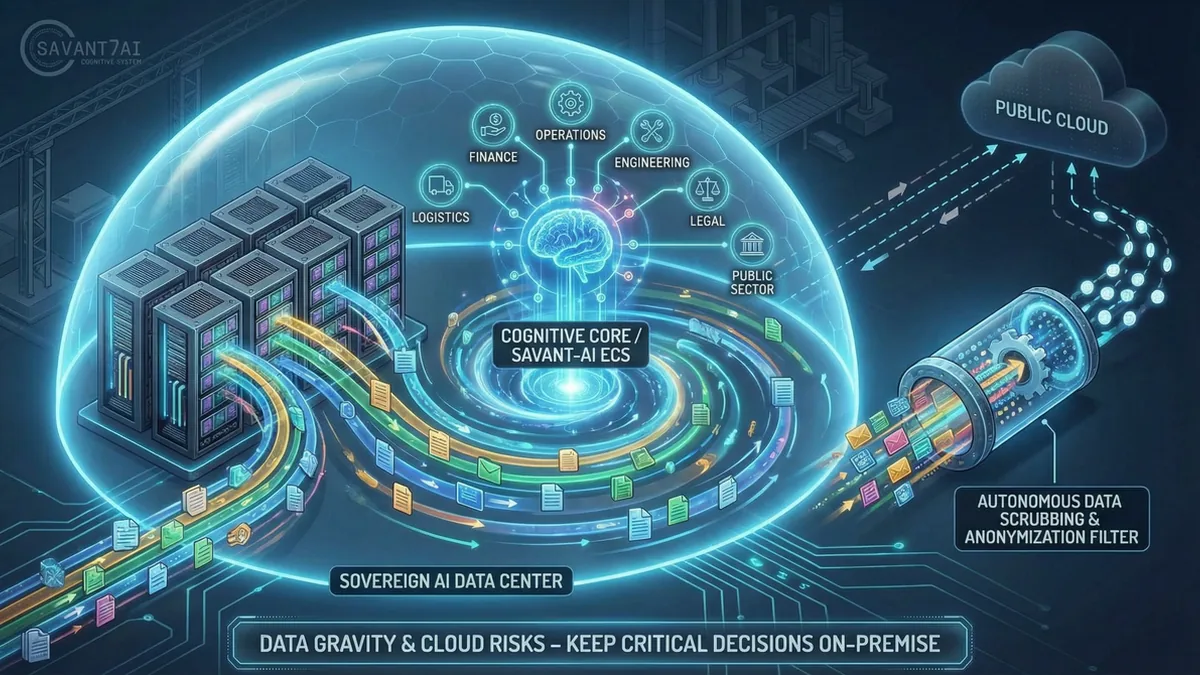
W erze generatywnej AI to dane — a nie serwery i aplikacje — stają się głównym źródłem władzy nad firmami, procesami i całymi gospodarkami. Grawitacja danych oznacza, że tam, gdzie fizycznie znajdują się dane, znajduje się również „mózg” organizacji i tam podejmowane są decyzje. Pytanie nie brzmi już „czy przejść do chmury”, lecz „które decyzje muszą pozostać suwerennie on-premise, pod pełną kontrolą właściciela danych”.
Ilustracja suwerennej lokalnej infrastruktury danych
Grawitacja danych w epoce AI
Grawitacja danych to zjawisko, w którym rosnące zbiory danych „przyciągają” do siebie aplikacje, modele i procesy decyzyjne, ponieważ przenoszenie danych jest kosztowne, powolne i ryzykowne. W praktyce miejsce przechowywania logów operacyjnych, danych transakcyjnych i dokumentacji technicznej staje się naturalnym centrum decyzyjnym organizacji.
W modelu SaaS i klasycznej chmurze publicznej środek tej grawitacji bardzo często znajduje się poza infrastrukturą firmy, a nawet poza jej jurysdykcją: tam trenuje się modele, analizuje zachowania klientów i tworzy rekomendacje, które kierownictwo jedynie formalnie zatwierdza. Z czasem decyzje stają się funkcją cudzej infrastruktury i algorytmów, a organizacja traci rzeczywistą autonomię nad procesem decyzyjnym.
Opóźnienia, p99 i rzeczywiste SLA
AI generuje stały strumień zapytań do dużych, często nieustrukturyzowanych zbiorów; każde dodatkowe opóźnienie obniża jakość doświadczenia i efektywność zespołów. W chmurze główną barierą jest sieć: pakiety przemieszczają się przez łącza operatorskie i internet lub prywatne VPN-y, wprowadzając jitter i skoki opóźnień, które naruszają SLA p95/p99 w systemach czasu rzeczywistego.
On-premise dane i moc obliczeniowa znajdują się w tej samej sieci L2/L3, często w tej samej szafie, z łączami 25/40/100 GbE i deterministyczną ścieżką do pamięci masowej. GPU nie czekają na dane, łatwiej utrzymać wysokie wykorzystanie zasobów, a systemy OT, hale produkcyjne i handel mogą realnie polegać na inferencji zbliżonej do czasu rzeczywistego.
Ryzyka chmurowe w relacjach USA–UE
Dla wielu europejskich firm chmura w regionie UE wydawała się kompromisem między wygodą a regulacjami, lecz prawo nie kończy się na granicy centrum danych — kluczowe są własność dostawcy i jurysdykcja, której podlega. CLOUD Act i FISA 702 pozwalają władzom USA uzyskać dostęp do danych przechowywanych przez amerykańskie firmy, nawet jeśli serwery znajdują się w Europie.
Wyrok Schrems II unieważniający Privacy Shield wymusza dodatkowe zabezpieczenia i indywidualną ocenę ryzyka przy transferach do podmiotów podlegających prawu USA; sam „region UE” w chmurze nie gwarantuje zgodności z RODO ani suwerenności danych. Sektory finansowy, ochrony zdrowia, administracji i obronności nie mogą zakładać, że zagraniczny hiperskaler rozwiązuje za nie problem jurysdykcji i nadzoru.
Od zgodności do suwerenności
Zgodność jest dziś wymogiem minimalnym; celem jest suwerenność rozumiana jako zdolność do samodzielnego kształtowania polityki danych i AI, niezależnie od interesów obcych państw i korporacji. Dla Europy oznacza to potrzebę posiadania własnej infrastruktury, własnych modeli i własnych ekosystemów danych, w których europejskie instytucje określają reguły gry.
Branżowe aspekty suwerenności: dane wrażliwe, IP, przewaga
W finansach, energetyce, ochronie zdrowia, administracji publicznej i zaawansowanym przemyśle dane są jednocześnie dowodem, strategicznym zasobem i mapą najsłabszych punktów systemu. Utrata kontroli — nawet bez głośnego wycieku — może oznaczać utratę siły negocjacyjnej, zdolności do obrony infrastruktury krytycznej lub tempa innowacji.
W bankowości i ubezpieczeniach dane odzwierciedlają ryzyko kredytowe, zachowania klientów, oszustwa i mikroekonomię gospodarstw domowych; jeśli modele oceniające to ryzyko działają w środowisku dostępnym dla zagranicznych regulatorów, powstaje ryzyko „przejrzystości” europejskiego systemu finansowego. W administracji dane podatkowe i zdrowotne oraz rejestry ludności tworzą obraz społeczeństwa, którego analiza przez zagraniczne podmioty byłaby potężnym narzędziem wpływu.
W energetyce dane z sieci, SCADA, prognoz popytu i produkcji energii odnawialnej tworzą cyfrowego bliźniaka infrastruktury krytycznej; ich analiza pozwala zarówno optymalizować rynek, jak i identyfikować punkty podatne na sabotaż. W przemyśle i B+R suwerenność dotyczy modeli, know-how, parametrów procesów, receptur i dokumentacji projektowej — fundamentu przewagi nad firmami z USA i Chin, które często dysponują tańszym kapitałem i większym rynkiem krajowym.
Kiedy zasoby te trafiają do globalnych usług chmurowych, organizacja oddaje nie tylko informacje, ale również możliwość dogłębnej analizy źródeł własnej przewagi; każdy wyciek, przejęcie, sankcja lub zmiana prawa w kraju operatora natychmiast przekłada się na ryzyka biznesowe i polityczne.
Koszty transmisji i egress: kiedy grawitacja staje się podatkiem
Przy hurtowniach danych o skali petabajtów, archiwach multimodalnych i logach telemetrycznych grawitacja danych zmienia się w rzeczywisty „podatek od innowacji”. Każdy eksperyment wymagający przenoszenia danych między regionami lub chmurami generuje wysokie opłaty za egress, transfer międzyregionalny i między chmurami, a także dodatkowe opóźnienia i powierzchnię ataku.
W suwerennym modelu on-premise z nowoczesną obiektową pamięcią masową zwiększasz pojemność we własnym centrum danych, nie płacisz za „wyciąganie” własnych danych i umieszczasz moc obliczeniową tam, gdzie fizycznie znajdują się krytyczne zbiory danych. Pozwala to agresywnie eksperymentować z modelami i agentami bez ryzyka, że rachunki za chmurę zniszczą ROI projektów AI.
Suwerenność w wyścigu USA–Chiny–Europa
USA kontrolują globalne platformy chmurowe i Big Tech agregujący petabajty danych, Chiny łączą ogromny potencjał inżynierii AI z państwową strategią ekspansji technologicznej, a Europa przez lata oddawała kontrolę nad swoją infrastrukturą cyfrową podmiotom spoza UE.
Strategie „suwerennej chmury” i „suwerennej AI” są próbą odwrócenia tego trendu: dane i systemy decyzyjne krytyczne dla gospodarki mają podlegać prawu europejskiemu i być przetwarzane na infrastrukturze kontrolowanej przez podmioty z UE. Bez takiej zmiany Europa ryzykuje, że stanie się dostawcą danych i rynkiem dla modeli innych państw, a kluczowe decyzje biznesowe i publiczne będą podejmowane na zagranicznej infrastrukturze.
Architektura suwerennej AI on-premise: warstwa po warstwie
Aby „instytucjonalny mózg on-premise” był czymś więcej niż metaforą, architektura musi być precyzyjnie zdefiniowana.
- Warstwa sprzętowa — klastry serwerów z GPU, na przykład H100/L40, szybkie NVMe jako lokalna pamięć podręczna oraz skalowalna obiektowa pamięć masowa zgodna z S3 na dane źródłowe, wektory i archiwa; minimalizuje to „czekanie na dane” i maksymalizuje wykorzystanie GPU.
- Sieć i segmentacja — architektura spine-leaf 25/100 GbE, segmentacja VLAN/VXLAN, oddzielne domeny OT/IT oraz QoS dla ruchu inferencji i trenowania zapewniają deterministyczne, przewidywalne ścieżki do danych.
- Pamięć masowa i suwerenność — obiektowa, programowo definiowana pamięć masowa z wbudowanym szyfrowaniem, WORM/niezmiennością i air gapem, logicznym lub fizycznym, dla kopii krytycznych zapewnia elastyczność chmury bez rezygnacji z kontroli nad lokalizacją replikacji i metadanymi.
- Warstwa orkiestracji — Kubernetes i kontenery z zasadami node affinity, izolacją przestrzeni nazw oraz oddzieleniem środowisk regulowanych od mniej krytycznych łączą wymagania bezpieczeństwa z elastycznością DevOps.
- Warstwa kognitywna (ECS) — system kognitywny klasy enterprise, taki jak SAVANT-AI, obsługujący ingest danych, RAG, orkiestrację agentów, audyt i governance w całości w tej infrastrukturze, bez „wywoływania chmury”.
W wariancie air-gapped cały system jest fizycznie odcięty od internetu, co eliminuje kanały, którymi dane, logi lub metadane mogłyby wyciec na zewnątrz — jest to wymóg między innymi w obronności, wywiadzie i energetyce.
Dlaczego krytyczne decyzje powinny pozostać on-premise
Jeśli grawitacja danych oznacza, że decyzje podążają za danymi, utrzymywanie kluczowych zbiorów danych on-premise pozwala zachować grawitację decyzyjną po stronie organizacji. Zamiast wysyłać dane do cudzej chmury, wprowadzamy modele i agentów AI do własnej serwerowni jako suwerenny system kognitywny działający w granicach zdefiniowanych przez firmę i regulatorów.
Suwerenne architektury AI oparte na GPU, obiektowej pamięci masowej, izolacji sieciowej i konteneryzacji osiągają wydajność podobną do chmury bez oddawania kontroli nad danymi i kodem decyzyjnym. Organizacja decyduje, które modele uruchamiać, jak długo przechowywać logi inferencji, kto może audytować decyzje i jak wykorzystywać dane w kolejnych projektach — co ma kluczowe znaczenie w bankowości, energetyce i obronności.
SAVANT-AI jako suwerenny „mózg instytucjonalny” on-premise
SAVANT-AI ucieleśnia tę filozofię: zamiast kolejnej aplikacji chmurowej jest suwerennym Enterprise Cognitive System instalowanym na infrastrukturze klienta. System łączy dane z ERP, MES, PLM, systemów prawnych, dokumentacji technicznej i otwartych źródeł w jeden „układ nerwowy” organizacji, a cały proces — od ingestu, przez trenowanie modelu, po generowanie rekomendacji — pozostaje pod pełną kontrolą właściciela danych.
W rezultacie grawitacja danych pozostaje po stronie organizacji: SAVANT-AI „zbliża się” do istniejących danych, zamiast przenosić je do zewnętrznego silosu w chmurze. Dla branż regulowanych i firm budujących przewagę w B+R oznacza to, że cyfrowy mózg organizacji pozostaje tam, gdzie powinien — we własnym suwerennym środowisku, odpornym na napięcia geopolityczne i zmiany regulacyjne.