Jak w 12 miesięcy zbudować suwerenne Centrum Kompetencji SAVANT-AI (ECS)
SAVANT-AI to projekt badawczy programu inLABs. Opisane funkcje są celem badań, a nie dostępnym produktem. Status projektu: inLABs
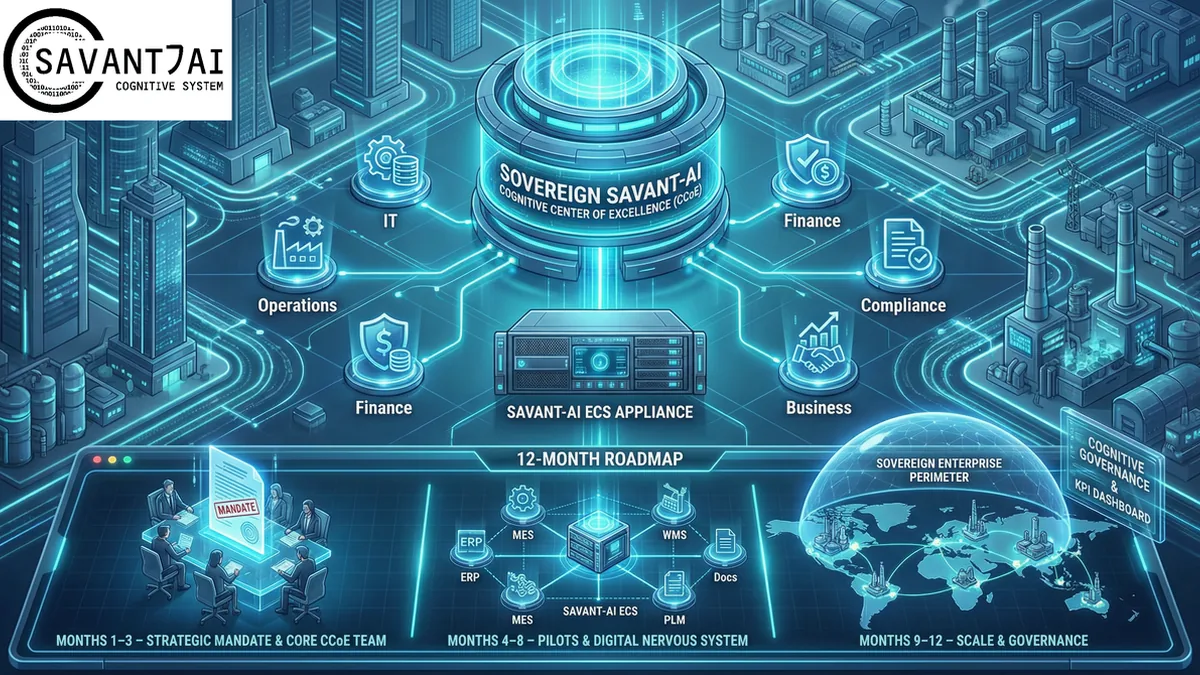
Centrum kompetencji AI to nie kolejna aplikacja, lecz zdolność organizacji. W projekcie badawczym SAVANT-AI sprawdzamy, jak ją wspierać technologicznie. Jej budowa wymaga ustanowienia Cognitive Center of Excellence (CCoE). Poniższa mapa drogowa określa proces przekształcania organizacji w organizm kognitywny — od mandatu strategicznego po globalne skalowanie inteligencji.

Miesiące 1–3: mandat strategiczny i budowa zespołu podstawowego (CCoE)
Na tym etapie kluczowe jest wyraźne osadzenie AI w strategii firmy.
- Mandat zarządu: powołanie Chief AI Architect z uprawnieniami do przełamywania silosów informacyjnych.
- Inwentaryzacja i pozyskanie korpusu początkowego: rozpoczęcie masowego gromadzenia „surowej wiedzy” z systemów DMS i repozytoriów PDF. Jest to etap budowania fundamentu tzw. Cognitive Knowledge Corpus.
- Utworzenie zespołu podstawowego (CCoE Core): grupa 6–8 specjalistów (405B Architect, TEE/Sentinel Engineer, MCP Developer, koordynatorzy HitL).
- Audyt silosów: identyfikacja punktów końcowych Model Context Protocol (MCP) dla systemów ERP i PLM.
Miesiące 3–6: pilotaż operacyjny i kalibracja „rdzenia prawdy”
Drugi kwartał to faza „rafinerii danych” — przekształcania surowych informacji w strukturę zrozumiałą dla Super Agenta.
- Budowa „złotego zbioru danych”: klastry ekspertów opracowują zestaw 500–1000 krytycznych par „pytanie–odpowiedź” (Ground Truth), które posłużą do rygorystycznego testowania dokładności systemu.
- Infrastruktura: uruchomienie środowiska AI on-premises, w razie potrzeby w izolacji air-gap.
- Indeksowanie i oczyszczanie: uruchomienie modułów anonimizacji i semantycznego oczyszczania korpusu danych.
- Pętla kalibracji (RLHF on-premise): eksperci weryfikują pierwsze syntezy, „szlifując” wagi merytoryczne modelu.
Miesiące 6–9: formalizacja nadzoru i standardów kognitywnych
CCoE przechodzi do ciągłego nadzoru nad przyrostem wartości wiedzy.
- Ciągła ingestia: uruchomienie automatycznych potoków danych, które w czasie rzeczywistym zasilają system nowymi faktami z systemów transakcyjnych.
- Wdrożenie macierzy uprawnień: implementacja modeli RAdAC i MAC.
- Eliminacja AI Sprawl: stopniowe wycofanie Shadow AI na rzecz suwerennej orkiestracji.
- Aktywacja Sentinel Audit: niezależny, redundantny nadzór nad procesami AI w czasie rzeczywistym.
Miesiące 9–12: skalowanie poziome (Cognitive Clustering)
Rozszerzenie inteligencji na całą globalną strukturę GMLC.
- Skalowanie: rozszerzenie infrastruktury na kolejne lokalizacje i wymiana wniosków między nimi.
- Katalog produktów kognitywnych: uruchomienie interfejsu Cameleoo dla 80% pracowników wiedzy.
- Przyrost wartości wiedzy: moment, w którym system zaczyna samodzielnie identyfikować „luki w bazie wiedzy” i prosi ekspertów o ich uzupełnienie.
:::note
Nota strategiczna 1: definicja i rygor RLHF on-premise
Proces RLHF (Reinforcement Learning from Human Feedback) prowadzony on-premises jest jednym z filarów suwerenności centrum kompetencji:
- Mentoring cyfrowy: umożliwia „szlifowanie” inteligencji modelu przez bezpośrednie poprawki merytoryczne wprowadzane przez klastry ekspertów. Model uczy się dialektu operacyjnego i ontologii organizacji.
- Ochrona kapitału intelektualnego: wszystkie poprawki merytoryczne nigdy nie opuszczają granic firmy, co uniemożliwia konkurencji uczenie się na jej know-how.
:::note
Nota strategiczna 2: budowa Cognitive Knowledge Corpus
Tworzenie korpusu danych treningowych nie jest jednorazowym importem, lecz procesem Fact Engineering:
- Ekstrakcja semantyczna: system nie tylko „czyta” pliki PDF, ale rozkłada je na fakty atomowe, przypisując im znaczniki suwerenności i znaczenia strategicznego.
- Utwardzanie prawdy: zespół CCoE wraz z ekspertami tworzy „złoty korpus”, który służy jako wzorzec obiektywnej prawdy. Na jego podstawie system uczy się, co w organizacji uznaje się za bezsporny fakt.
- Deidentyfikacja: zanim jakikolwiek fragment korpusu trafi do warstwy inferencji, przechodzi przez filtr anonimizacji, który chroni dane osobowe zgodnie z RODO, zachowując pełną wartość techniczną informacji.