Dlaczego 200 PFLOPS zmieni fizykę biznesu w 2026 roku?
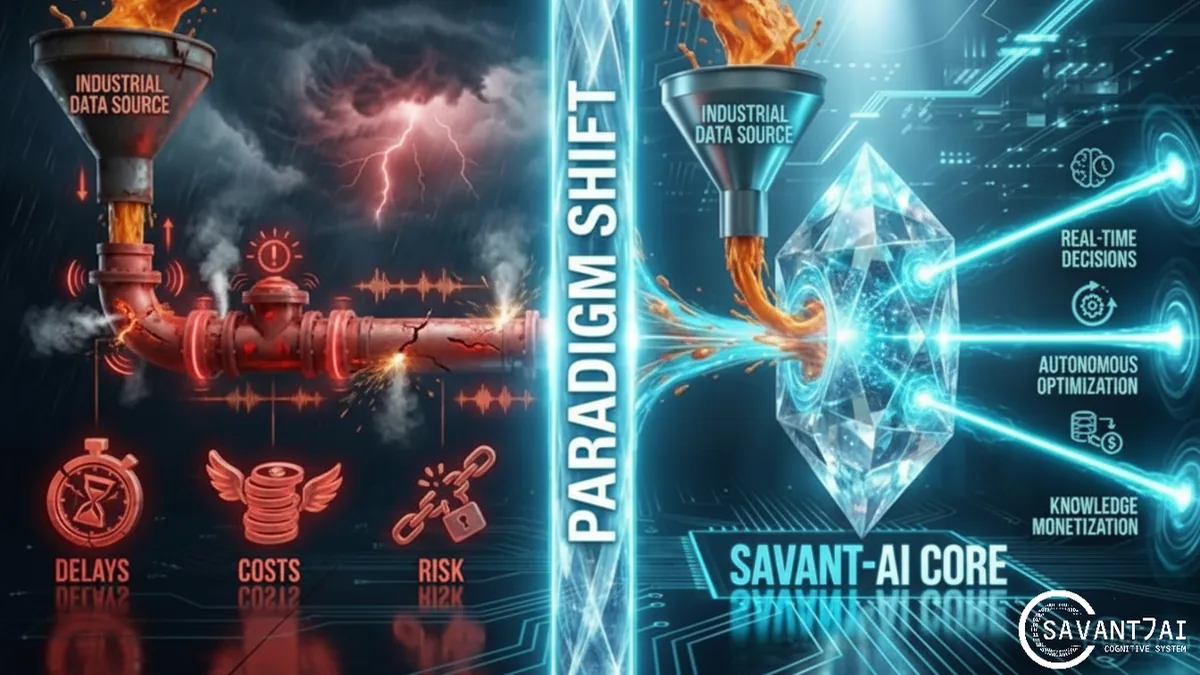
W globalnej korporacji przemysłowej każda sekunda opóźnienia w dostępie do wiedzy kosztuje tysiące euro — a każda dodatkowa milisekunda opóźnienia bezpośrednio uderza w EBITDA. To nie retoryka marketingowa, lecz konsekwencja zjawiska nazywanego przez fizyków danych Data Gravity. Petabajty danych generowanych przez systemy MES, PLM i ERP osiągają masę krytyczną, przy której próba przeniesienia ich do chmury publicznej generuje koszty transmisji i opóźnienia niwelujące wszelkie korzyści z użycia sztucznej inteligencji. W realiach produkcji przemysłowej, gdzie linia montażowa nie toleruje przestojów, odległość między źródłem informacji a jednostką obliczeniową przestaje być parametrem technicznym — staje się wyznacznikiem rentowności całego przedsiębiorstwa. Właśnie tutaj suwerenna infrastruktura kognitywna on-premise taka jak SAVANT-AI zmienia ekonomikę AI z „ładnego demo” w „produkcyjny silnik zysku”.
Ilustracja suwerennej wysokowydajnej infrastruktury kognitywnej
Tradycyjna architektura chmurowa zakłada, że dane mogą swobodnie migrować do hiperskalowych centrów obliczeniowych. Założenie to zawodzi w konfrontacji z przemysłową rzeczywistością globalnych konglomeratów. Gdy inżynier utrzymania w zakładzie produkcyjnym potrzebuje natychmiastowej syntezy faktu dotyczącego procedury naprawy krytycznej maszyny, każda milisekunda opóźnienia w przesyłaniu zapytania przez warstwy sieciowe przekłada się na rzeczywistą stratę. Badania branżowe wskazują, że wysoko wykwalifikowani pracownicy wiedzy tracą do kilku procent czasu pracy na bezproduktywne przeszukiwanie rozproszonych zasobów informacyjnych. W skali globalnego konglomeratu daje to dziesiątki milionów euro rocznie — kapitał marnowany przez architekturę traktującą opóźnienie jako dopuszczalny parametr. Odpowiedzią na to systemowe wyzwanie nie jest kolejna platforma analityczna ani chmurowy asystent subskrypcyjny. Odpowiedzią jest fundamentalna zmiana paradygmatu: przeniesienie mocy obliczeniowej tam, gdzie powstają dane.
Architektura NVIDIA HGX B300 (Blackwell Ultra) dostarcza 200 PFLOPS mocy obliczeniowej w trybie FP8 — wydajność pozwalającą generować syntezę wiedzy w milisekundach zamiast sekund. System ma łącznie 2,3 TB VRAM (HBM3e), dzięki czemu obsługuje modele z 405 miliardami parametrów przy pełnej precyzji numerycznej bez pogarszania jakości przez kwantyzację. Przepustowość międzyprocesowa NVLink osiąga 1,8 TB/s, eliminując wąskie gardła w procesach orkiestracji wieloagentowej. Specyfikacja nie jest abstrakcyjną wartością techniczną — bezpośrednio przekłada się na zdolność Enterprise Cognitive System (ECS) do prowadzenia inferencji w czasie rzeczywistym. W praktyce oznacza to, że SAVANT-AI może wykonywać tysiące równoległych, w pełni ugruntowanych zapytań inżynierów, specjalistów ryzyka lub zespołów zakupowych, utrzymując dla każdego użytkownika czas odpowiedzi w niskim zakresie milisekundowym.
SAVANT-AI, suwerenna infrastruktura kognitywna oparta na architekturze Blackwell, wykorzystuje paradygmat Permanent Model Residency. Każda jednostka inteligencji — od orkiestratora Llama-3 405B, przez siedmiu agentów domenowych klasy 70B, po deterministyczny moduł weryfikacji faktów — stale przebywa w dedykowanej przestrzeni pamięci akceleratora. Nie ma „cold start” ani przełączania modeli; każdy mózg domenowy jest zawsze aktywny i gotowy do odpowiedzi. Zerowe opóźnienie przełączania kontekstu oznacza, że złożone zapytanie wymagające korelacji danych z ERP, PLM i MES otrzymuje odpowiedź w milisekundach, a nie sekundach czy minutach typowych dla rozwiązań opartych na zdalnej inferencji. Dla inżyniera utrzymania lub specjalisty ryzyka jest to różnica między oczekiwaniem 20–40 sekund na zdalnego chatbota a uzyskaniem w pełni ugruntowanej odpowiedzi w czasie poniżej 200 ms, bezpośrednio w fabryce lub na parkiecie transakcyjnym.
Krytycznym aspektem architektury Blackwell, często pomijanym w dyskusjach skupionych wyłącznie na wydajności obliczeniowej, jest implementacja technologii Confidential Computing. W akceleratorach HGX B300 znajdują się Trusted Execution Environments (TEE) — sprzętowe enklawy w pamięci HBM3e, całkowicie odizolowane od warstwy systemu operacyjnego i procesów nienależących do certyfikowanego rdzenia kognitywnego. Dane finansowe, receptury procesowe, strategie cenowe i unikatowe parametry technologiczne są przetwarzane w zaszyfrowanych, nieprzeniknionych kapsułach krzemowych. Suwerenność w rozumieniu SAVANT-AI nie jest obietnicą prawną ani certyfikatem zgodności — jest fizyką krzemu, absolutną barierą gwarantowaną przez architekturę sprzętową. Suwerenność zakotwiczona sprzętowo zamyka kluczowe kwestie regulacyjne organizacji bankowych, energetycznych i sektora publicznego działających w reżimach RODO, NIS2 i DORA.
Model ekonomiczny rozwiązań chmurowych opiera się na zmiennych kosztach operacyjnych (OpEx), rosnących proporcjonalnie do skali adopcji systemu w organizacji. Paradoks ten można opisać jako „podatek od sukcesu” — im większą wartość organizacja czerpie z AI, tym wyższy rachunek otrzymuje od dostawcy chmury. Architektura SAVANT-AI Appliance odwraca tę logikę, przekształcając zmienne koszty operacyjne w jednorazowy wydatek kapitałowy (CapEx), który amortyzuje się z każdą sesją orkiestracji wiedzy. Analiza Total Economic Impact dla globalnego konglomeratu produkcyjnego pokazuje skumulowane NPV wielokrotnie przekraczające inwestycję początkową w horyzoncie pięcioletnim, nawet przy konserwatywnych założeniach adopcji i produktywności. Dominującym motorem tego efektu jest ograniczenie Mean Time to Synthesis (MTTS) — średniego czasu potrzebnego pracownikowi wiedzy do uzyskania zweryfikowanego faktu — o dziesiątki punktów procentowych w inżynierii, operacjach i funkcjach ryzyka.
Kluczową przewagą SAVANT-AI nad tradycyjnymi platformami analitycznymi jest mechanizm deterministycznej weryfikacji faktów (Factual Grounding) połączony z technologią Deep Citation. System nie generuje prawdopodobnych odpowiedzi w sposób charakterystyczny dla probabilistycznych modeli językowych — wykonuje proces orkiestracji faktów, w którym każda teza musi być uzasadniona dowodem źródłowym. Każdej liczbie prezentowanej w interfejsie decyzyjnym Cameleoo towarzyszy aktywny link prowadzący do konkretnej strony dokumentacji PDF, rekordu w ERP lub wpisu w bazie wiedzy PLM. Mechanizm Source Traceability czyni proces inferencji w pełni audytowalnym, co jest warunkiem zgodności z normami ISO, regulacjami branżowymi i wymaganiami audytu wewnętrznego. Dla komitetów audytu i rad nadzorczych oznacza to, że każdą decyzję wspartą przez AI można odtworzyć, uzasadnić i obronić wiele lat po jej podjęciu.
Ilustracja weryfikacji faktów i orkiestracji agentów
Wieloagentowa architektura SAVANT-AI opiera się na standardzie Model Context Protocol (MCP), który stanowi uniwersalny fundament integracji z korporacyjnymi systemami źródłowymi. Zamiast budować kosztowne konektory dedykowane każdej parze system–model, MCP wprowadza architekturę klient–serwer, w której systemy transakcyjne udostępniają zasoby przez ujednolicone serwery kontekstu. Zmienia to integrację z niekończącego się projektu SI w standaryzowany wzorzec, skracając time-to-value nowych przypadków użycia z miesięcy do tygodni. Główny orkiestrator kognitywny (Llama-3 405B) rozkłada złożone pytania biznesowe na podzadania delegowane wyspecjalizowanym agentom domenowym odpowiedzialnym za pozyskanie wiedzy z konkretnych silosów danych. Agenci nie tylko wymieniają informacje, ale także wzajemnie weryfikują wnioski przed agregacją, co radykalnie ogranicza ryzyko halucynacji charakterystyczne dla monolitycznych systemów generatywnych.
Standard izolacji air gap wdrożony w architekturze SAVANT-AI Appliance fizycznie odcina jednostkę obliczeniową od publicznego internetu. Jest odpowiedzią na dwa fundamentalne zagrożenia: ataki Advanced Persistent Threat (APT) wymierzone w strategiczną własność intelektualną oraz ryzyko cichego przenikania danych do infrastruktury dostawców chmury publicznej. Procedury zarządzania aktualizacjami opierają się na mechanizmie Secure Gate wykorzystującym jednokierunkowe łącza danych — diody danych — co pozwala bezpiecznie dostarczać nowe wersje modeli bez narażania systemu na kompromitację łańcucha dostaw oprogramowania. Model ten ogranicza ryzyko finansowe związane z wyciekiem danych strategicznych — ryzyko, które w razie materializacji mogłoby kosztować globalny konglomerat przemysłowy setki milionów euro. Z perspektywy zarządu SAVANT-AI Appliance odizolowany air gapem działa jak cyfrowa zapora: ogranicza promień rażenia każdego cyberincydentu z założenia, a nie jedynie dzięki polityce.
Organizacje przemysłowe stoją obecnie przed egzystencjalnym wyborem. Kontynuowanie strategii opartej na rozproszonych rozwiązaniach chmurowych prowadzi do utrwalenia AI Sprawl — chaosu technologicznego, w którym dziesiątki nieskoordynowanych inicjatyw AI generują koszty bez budowania trwałej przewagi konkurencyjnej. Alternatywą jest konsolidacja wokół suwerennej infrastruktury kognitywnej, która przekształca dane w wiedzę strategiczną tam, gdzie dane powstają. SAVANT-AI oparty na architekturze NVIDIA Blackwell HGX B300 nie jest kolejnym narzędziem w arsenale IT — jest cyfrowym układem nerwowym korporacji, zdolnym do orkiestracji wiedzy w czasie rzeczywistym, z suwerennością gwarantowaną na poziomie fizyki krzemu.
W ciągu najbliższych 2–3 lat planowanie budżetu CapEx na wdrożenie SAVANT-AI Appliance w trybie air gap będzie traktowane jak inwestycja w infrastrukturę krytyczną, analogiczna do zakupu generatorów awaryjnych lub systemów przeciwpożarowych. Różnica polega na tym, że ta infrastruktura nie chroni przed stratą, lecz buduje zdolność monetyzowania wiedzy organizacji w tempie nieosiągalnym dla konkurentów działających w modelu wynajmu kognitywnego. Organizacje bez suwerennej infrastruktury ECS w 2026 roku zapłacą hiperskalerom podatek od sukcesu albo — co gorsza — nie będą miały „sukcesu do opodatkowania”. Dla CIO, CFO i Chief Risk Officers praktyczny kolejny krok jest prosty: potraktować SAVANT-AI Appliance jako pozycję w planie CapEx infrastruktury krytycznej na lata 2026–2027. Organizacje, które ruszą wcześnie, zabezpieczą suwerenność obliczeniową na poziomie 200 PFLOPS, podczas gdy ich konkurenci będą nadal negocjować ceny AI oparte na zużyciu.