Open source czy vendor lock-in: dlaczego największe banki świata wybierają otwarte stosy AI — i co to oznacza dla twojej organizacji
Wyobraź sobie, że budujesz strategiczny system AI dla swojej organizacji. Wybierasz czołowego dostawcę chmury, integrujesz jego modele i budujesz procesy wokół jego API. System działa znakomicie. Przez dwa lata wszystko przebiega zgodnie z planem.
Potem dostawca zmienia warunki cenowe o 40%. Albo organ regulacyjny w twoim kraju uznaje, że dane przetwarzane przez ten system nie mogą opuszczać UE. Albo Departament Sprawiedliwości USA wydaje nakaz dostępu do danych przechowywanych przez tę firmę — a na mocy amerykańskiego CLOUD Act dostawca musi go wykonać, niezależnie od tego, że twoje serwery znajdują się w Warszawie.
To nie są scenariusze z filmów science fiction. To rzeczywiste ryzyka. Właśnie dlatego kilka największych banków świata podjęło strategiczną decyzję, która na pierwszy rzut oka może zaskakiwać: przyjęły strategię „open-source first” dla swoich stosów generatywnej AI.
Trzy regulacje zmieniające ekonomię chmury
Zanim przejdziemy do kwestii technicznych, warto zrozumieć, dlaczego temat open source i suwerenności AI stał się pilny właśnie teraz. Chodzi o zbieg trzech wektorów regulacyjnych, które razem tworzą całkowicie nową rzeczywistość prawną dla każdej organizacji przetwarzającej dane w chmurze.
US CLOUD Act (2018, skutki do dziś)
Ustawa wymaga od firm zarejestrowanych w USA ujawnienia danych na żądanie organów ścigania — nawet jeśli dane fizycznie znajdują się za granicą. Oznacza to, że europejska firma korzystająca z AWS, Azure lub Google Cloud nie ma pełnej ochrony prawnej swoich danych, nawet gdy serwery znajdują się we Frankfurcie lub Warszawie.
EU AI Act (obowiązuje od 2025 roku)
Rozporządzenie nakłada obowiązki w zakresie audytowalności, przejrzystości i zarządzania ryzykiem dla systemów AI wysokiego ryzyka. Systemy AI zamknięte w zewnętrznych czarnych skrzynkach dostawców stają się ryzykiem prawnym — organizacja musi udowodnić regulatorowi, że rozumie działanie modelu i potrafi interweniować. Bez dostępu do kodu i architektury modelu jest to niemożliwe.
Chińskie prawo bezpieczeństwa danych i cyberbezpieczeństwa
Choć dla europejskich organizacji jest to mniej oczywiste, ma znaczenie pośrednie: firmy korzystające z rozwiązań AI opartych na modelach trenowanych przez chińskie przedsiębiorstwa technologiczne mogą podlegać wymogom transferu danych do Chin.
Łącznie te trzy regulacje tworzą sytuację, w której organizacja może przestrzegać prawa jednego państwa, a jednocześnie naruszać prawo innego — wyłącznie wskutek wyboru dostawcy chmury lub modelu AI. Tego problemu nie rozwiąże lepszy prawnik. To problem architektoniczny.
Dlaczego banki wybrały open source — i czego można się od nich nauczyć
Trend rozpoczęty w sektorze finansowym szybko rozprzestrzenia się na inne branże regulowane: kilka największych banków świata przyjęło strategie open-source-first dla stosów generatywnej AI, obejmujących agentów, bazy wektorowe, bramy API i warstwy obserwowalności.
Istnieją trzy powody, każdy równie ważny:
1. Audytowalność i zgodność regulacyjna
Bank musi być w stanie wyjaśnić organowi nadzoru, jak działa każdy algorytm wpływający na decyzje kredytowe, scoringowe lub transakcyjne. Zamknięty model SaaS na to nie pozwala. Model open source — tak. Regulator może zobaczyć architekturę, dane treningowe i mechanizmy ewaluacji. To nie luksus — w coraz większej liczbie jurysdykcji jest to wymóg prawny.
2. Przenośność i unikanie vendor lock-in
Otwarte frameworki — LangChain, Haystack, Ray i Kubernetes — umożliwiają wdrożenia wielochmurowe, w których komponenty systemu AI można przenosić między dostawcami lub migrować on-premise bez przepisywania całego stosu. Jest to dosłowna realizacja zasady przenośnej architektury, którą rekomendujemy jako jedną z sześciu strategii suwerenności cyfrowej dla CIO.
3. Kontrola nad danymi treningowymi i fine-tuningiem
Banki dysponują milionami dokumentów, transakcji i interakcji z klientami — danymi będącymi jednocześnie ich największym zasobem i największym ryzykiem zgodności. Open source pozwala prowadzić fine-tuning modeli lokalnie, bez wysyłania danych do zewnętrznych API. Dane nigdy nie opuszczają kontrolowanego środowiska.
Open source jako warstwa suwerenności — nie ideologia, lecz inżynieria
Ważne zastrzeżenie: strategia open-source-first nie oznacza odrzucenia wszystkich dostawców zewnętrznych. Oznacza świadomy wybór, które warstwy stosu muszą być otwarte i kontrolowane, a gdzie można korzystać z usług zewnętrznych.
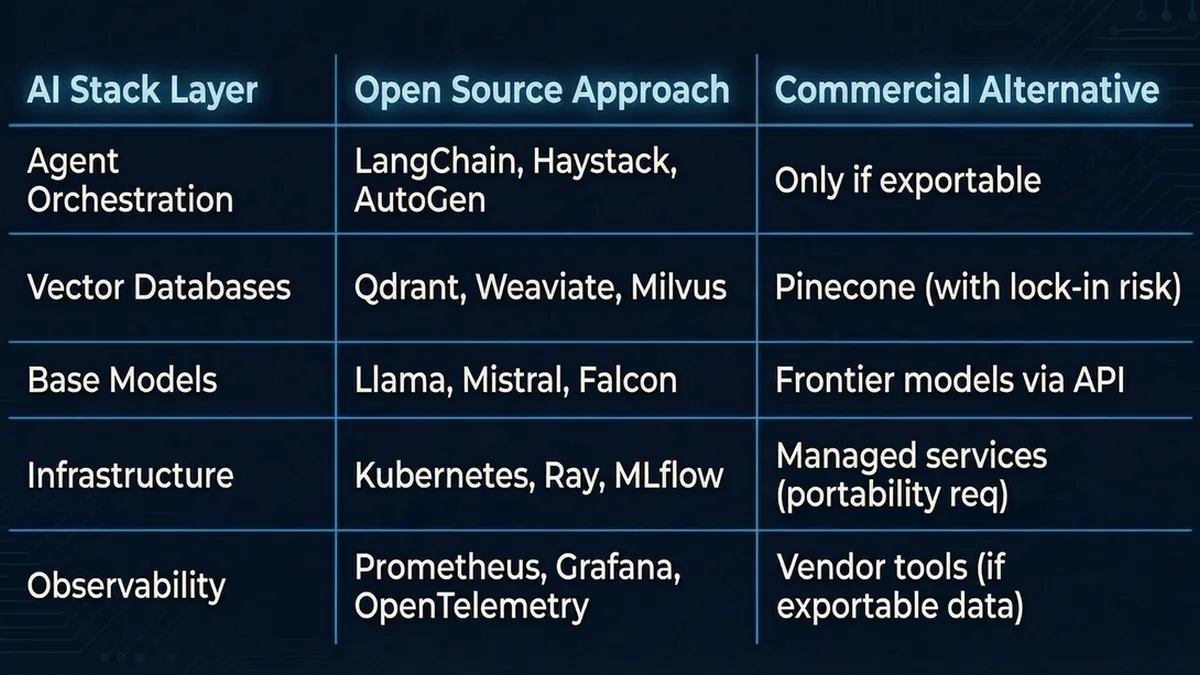
Strategie open source w warstwach stosu AI — w praktyce wygląda to następująco:
Ilustracja otwartego i suwerennego stosu technologicznego AI
Kluczowa zasada: wszystko, co styka się z danymi wrażliwymi lub wpływa na decyzje wysokiego ryzyka, musi być otwarte, audytowalne i kontrolowane lokalnie. Reszta może korzystać z globalnych platform, pod warunkiem że architektura pozostaje przenośna.
5 pytań do dostawcy AI przed podpisaniem umowy
Niezależnie od tego, czy jesteś w trakcie przetargu, oceniasz istniejące umowy, czy dopiero budujesz strategię AI, tych pięć pytań pozwoli odróżnić rzeczywiście suwerennych dostawców od tych, którzy używają słowa „suwerenny” jako etykiety marketingowej:
- Czy możecie pokazać pełną architekturę modelu i stos technologiczny — w tym zależności od usług zewnętrznych i API?
- Gdzie fizycznie znajdują się moje dane podczas trenowania, fine-tuningu i inferencji — i jakiej jurysdykcji prawnej podlegają?
- Czy po rozwiązaniu umowy mogę wyeksportować model, dane i całą konfigurację bez utraty funkcjonalności?
- Jak system spełnia wymagania audytowalności EU AI Act — czy mogę zobaczyć logi decyzji, wagi modelu i dokumentację ryzyka?
- Co stanie się z moimi danymi, jeśli wasza firma zostanie przejęta, zbankrutuje lub zmieni warunki świadczenia usług?
Jeśli dostawca nie potrafi odpowiedzieć na te pytania precyzyjnie i na piśmie, ryzykujesz vendor lock-in, niezależnie od tego, jak wygląda jego marketing.
Jak GENESIS-AI i SAVANT-AI opierają się na otwartych standardach
W allclouds.pl od pierwszego dnia zdecydowaliśmy, że architektura naszych produktów będzie oparta na otwartych standardach — nie dlatego, że to modne, lecz dlatego, że nasi klienci są organizacjami regulowanymi, które muszą umieć odpowiedzieć na każde z powyższych pytań bez nerwowego zerkania na klauzule umowne.
SAVANT-AI — nasz suwerenny system kognitywny dla przedsiębiorstw — działa on-premise lub w zaufanej chmurze europejskiej, korzysta z otwartych frameworków orkiestracji, obsługuje lokalne modele open source, w tym polskojęzyczne warianty Mistral i Llama, oraz zapewnia pełną audytowalność każdej decyzji zgodnie z wymaganiami EU AI Act.
GENESIS-AI — autonomiczna platforma generowania oprogramowania — jest zbudowana na otwartych standardach, co oznacza, że kod wygenerowany przez system należy w 100% do klienta, nie jest udostępniany zewnętrznym API i może być audytowany, modyfikowany oraz wdrażany bez żadnych ograniczeń licencyjnych.
Obie platformy spełniają wymagania NIS2 dotyczące bezpieczeństwa łańcucha dostaw oprogramowania — ponieważ wiemy, że dla naszych klientów z sektorów finansowego, energetycznego i publicznego nie jest to opcja, lecz warunek konieczny.
Suwerenność dzięki otwartości — nie izolacji
Paradoks suwerennej AI polega na tym, że prawdziwa suwerenność nie wynika z odcięcia się od świata — lecz z architektury, która daje wybór. Wybór dostawcy. Wybór jurysdykcji. Wybór modelu. Wybór ścieżki audytu.
Open source jest narzędziem tego wyboru. Nie eliminuje wszystkich zależności — ale czyni je świadomymi, kontrolowanymi i odwracalnymi.
W świecie, w którym US CLOUD Act, EU AI Act i nasilająca się geopolityka technologiczna na nowo definiują znaczenie „moich danych” i „mojego systemu AI”, architektura oparta na otwartych standardach przestaje być wyborem filozoficznym. Staje się zarówno przewagą konkurencyjną, jak i wymogiem zgodności.
Chcesz zobaczyć, jak otwarty stos AI wygląda w praktyce?
Dołącz do sesji technicznej z architektem SAVANT-AI — pokażemy kompletną mapę zależności naszego stosu, dokumentację zgodności z EU AI Act i NIS2 oraz odpowiemy na każde z pięciu powyższych pytań w odniesieniu do naszego systemu.