Masz suwerenność danych, ale nie masz suwerennej AI: dlaczego Europa sama się hamuje
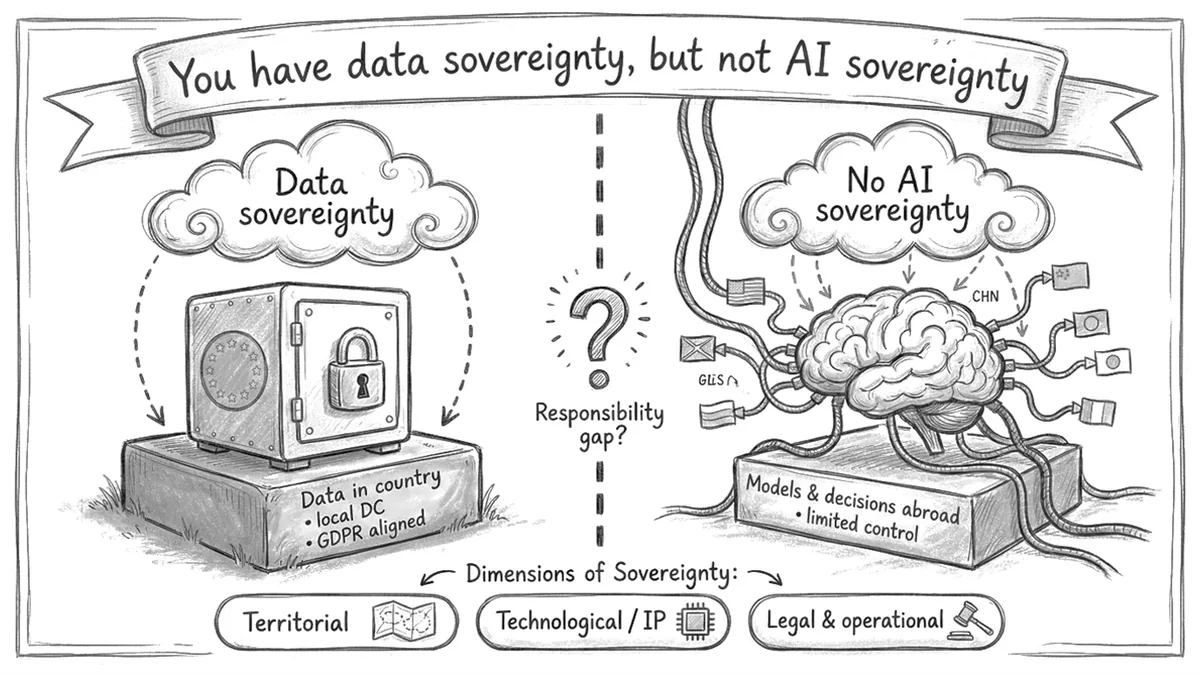
W wielu europejskich firmach i instytucjach panuje przekonanie, że kwestię suwerenności technologicznej można już „odhaczyć”: dane są przechowywane w lokalnych centrach danych, dostawca chmury ma region w UE, a umowa wskazuje jurysdykcję europejską. W prezentacjach wszystko wygląda bezpiecznie i zgodnie z regulacjami.
Problem polega na tym, że to tylko połowa historii. Można mieć pełną suwerenność danych, a jednocześnie nie mieć żadnej suwerenności w warstwie inteligencji, czyli tam, gdzie podejmowane są decyzje oraz działają modele, agenci i systemy rekomendacyjne. Właśnie dlatego Europa grzęźnie na własnej przewadze: ma dane, regulacje i przemysł, lecz zbyt często zleca na zewnątrz „mózg” systemu.
Article illustration
Suwerenność danych to nie to samo co suwerenność AI
Suwerenna sztuczna inteligencja nie polega na „ustawieniu serwera w kraju”. Chodzi o zdolność państwa lub organizacji do samodzielnego tworzenia, utrzymywania i kontrolowania systemów AI opartych na własnych zasobach: infrastrukturze, danych, modelach i ludziach, a także na własnych zasadach, jurysdykcji i systemie wartości.
Tak rozumiana suwerenność ma cztery wymiary:
- Terytorialny - gdzie fizycznie znajdują się dane i zasoby obliczeniowe.
- Operacyjny - kto może nimi zarządzać, wyłączać je, modyfikować i utrzymywać.
- Technologiczny/IP - kto jest właścicielem stosu technologicznego oraz praw własności intelektualnej do modeli i kodu.
- Prawny - czyja jurysdykcja ma zastosowanie, gdy coś pójdzie nie tak.
Suwerenność danych koncentruje się głównie na pierwszym i częściowo czwartym wymiarze: lokalizacji i prawie właściwym dla przetwarzania danych. Suwerenna AI idzie znacznie dalej: dotyczy warstwy inteligencji, a konkretnie tego, kto „posiada” logikę decyzyjną systemu.
Można zatem przechowywać dane w kraju, a całą warstwę inteligencji - modele, agentów i orkiestrację - pozostawić w rękach dostawców zewnętrznych. W takim układzie masz suwerenność danych, lecz nie masz suwerennej AI.
To nie ideologia, lecz twarda ekonomia
Suwerenność AI łatwo zbyć jako samą „politykę” lub „ideologię”. Stawka jest jednak bardzo praktyczna.
Po pierwsze, coraz większa część wartości gospodarczej będzie pochodzić z rozwiązań suwerennych lub „wystarczająco suwerennych” - szczególnie w branżach regulowanych: ochronie zdrowia, finansach, sektorze publicznym, obronności i energetyce. Tam, gdzie w grę wchodzą wysoce wrażliwe dane i znacząca odpowiedzialność, trudno polegać wyłącznie na czarnych skrzynkach zarządzanych z innego kontynentu.
Po drugie, dla Europy suwerenna AI oznacza realny potencjał wzrostu. Raport Draghiego z września 2024 roku - najbardziej wpływowa analiza konkurencyjności UE w ostatniej dekadzie - szacuje, że zamknięcie luki produktywności wobec Stanów Zjednoczonych i Chin wymaga dodatkowych inwestycji w wysokości 750-800 miliardów euro rocznie, a technologie cyfrowe skupione wokół AI są jednym z trzech kluczowych filarów tej odpowiedzi. W scenariuszu „suwerenności cyfrowej” część tej wartości pozostaje w regionie: w centrach danych, zespołach budujących modele i firmach dostarczających aplikacje. W scenariuszu alternatywnym odpływa wraz z marżą zysku.
Po trzecie, jeżeli państwo lub duży sektor polega wyłącznie na zagranicznych modelach dostępnych przez API, to:
- eksportuje dane i wiedzę za granicę,
- importuje gotowe usługi o wysokiej marży,
- i daje innym możliwość trenowania modeli we własnym kontekście.
Rezultat jest prosty: państwo staje się przede wszystkim rynkiem i źródłem „paliwa danych”, a nie współtwórcą technologii. Nie jest to neutralny wybór - dotyczy miejsca tworzenia wartości i rozwijania kompetencji.
Trzy powody, dla których suwerenna AI trafia do agend zarządów
Temat suwerennej AI wychodzi już poza wąskie kręgi specjalistów ds. cyberbezpieczeństwa i regulacji. Pojawia się na posiedzeniach rad nadzorczych, zarządów i w dyskusjach ministrów. Napędzają go co najmniej trzy siły.
1. Odpowiedzialność prawna i jej krystalizacja w regulacjach
Sądy coraz częściej orzekają, że podmiot wdrażający AI odpowiada za konsekwencje jej działania: stronniczość, błędne decyzje i szkody wynikające z użycia systemu. Dostawcy modeli dokładają wszelkich starań, aby ograniczyć swoją odpowiedzialność w umowach.
Te abstrakcyjne zasady odpowiedzialności zaczynają dziś krystalizować się w konkretnych regulacjach, które redefiniują znaczenie „używania AI w sektorze regulowanym”:
- DORA - obowiązująca od stycznia 2025 roku - wymaga od instytucji finansowych zapewnienia operacyjnej odtwarzalności każdej decyzji systemu i pełnego raportowania incydentów.
- EU AI Act dla systemów wysokiego ryzyka - scoringu kredytowego, HR, infrastruktury krytycznej, administracji publicznej i wymiaru sprawiedliwości - wymaga audytowalności, nadzoru człowieka i dokumentacji cyklu życia modelu.
- NIS2 wymaga ścisłej kontroli dostępu i zdolności reagowania na incydenty w podmiotach krytycznych i kluczowych.
Te trzy regulacje mają wspólny mianownik: wymagają od wdrażającego zdolności odtworzenia, wyjaśnienia i skorygowania decyzji systemu. Zdolności tej strukturalnie brakuje, jeżeli warstwa inteligencji znajduje się poza jego kontrolą. Gdy krytyczne decyzje podejmuje model, nad którym nie mamy rzeczywistej kontroli - nad architekturą, trenowaniem, danymi i zmianami wersji - tworzymy lukę między odpowiedzialnością prawną a faktycznym wpływem na system. Suwerenna AI pozwala zawęzić tę lukę dzięki audytowalności, możliwości interwencji i jasnemu łańcuchowi odpowiedzialności.
2. Odporność geopolityczna
Zależność od kilku globalnych dostawców niesie ryzyko „wyłączenia awaryjnego”: przerw w dostępie do usług, konsekwencji sporów handlowych, sankcji i napięć politycznych. Nie jest to problem czysto abstrakcyjny - dotyczy sektorów krytycznych: infrastruktury, administracji i obronności.
Suwerenna AI nie oznacza odcinania się od świata, lecz zapewnienie, że w kluczowych obszarach państwo i duże organizacje mają plan B, C i D, który nie opiera się na nadziei, że „dostawca nas nie odetnie”.
3. Przechwytywanie wartości
Jeśli cały „mózg” systemów AI znajduje się w stosie zewnętrznych graczy, lokalne firmy płacą za licencje i usługi, globalni dostawcy gromadzą zyski, dane o zachowaniu użytkowników i know-how, a lokalne ekosystemy innowacji rozwijają się wolniej, ponieważ najciekawsze problemy rozwiązano już gdzie indziej.
Suwerenna AI jest próbą odwrócenia tego trendu: zatrzymania większej części wartości w kraju lub regionie.
Dzisiejsza Europa: suwerenne dane, zależna inteligencja
Analiza wielu inicjatyw w Europie ujawnia wyraźny wzorzec:
- dane są przechowywane lokalnie,
- centra danych znajdują się na terytorium Europy,
- w chmurze istnieją „suwerenne regiony”,
- politycy z dumą mówią o „suwerenności danych”.
Jednocześnie kluczowe modele są rozwijane i aktualizowane poza Europą, inferencja - rzeczywiste „myślenie” systemu - odbywa się w środowiskach kontrolowanych przez dostawców zewnętrznych, a lokalne zespoły często używają AI jako gotowego narzędzia, nie jako czegoś, co współprojektują.
Warstwa danych jest suwerenna, ale warstwa inteligencji nie. W praktyce oznacza to między innymi ograniczoną możliwość dostrajania modeli do lokalnych realiów prawnych, językowych i kulturowych; trudności z zapewnieniem pełnej zgodności z europejskimi regulacjami; oraz hamowanie adopcji AI w sektorach regulowanych, gdzie próg akceptacji ryzyka jest wyższy.
Jest jeszcze jedna rzecz, której nie można pominąć w 2026 roku, choć zaledwie dwa lata temu była marginalna w europejskim dyskursie. Mówiąc o „zewnętrznych dostawcach modeli”, coraz częściej nie odnosimy się już wyłącznie do stosu amerykańskiego. Chińskie laboratoria - DeepSeek, Qwen Alibaby, GLM firmy Zhipu i MiniMax - w ciągu ostatnich osiemnastu miesięcy opublikowały rodzinę modeli, które w wielu benchmarkach nie tylko dorównują najlepszym modelom amerykańskim, ale w odróżnieniu od nich są dostępne na otwartych licencjach do pobrania i wdrożenia we własnej infrastrukturze. Dla dyskusji o suwerenności AI w Europie jest to zmiana układu sił, której większość publikacji branżowych jeszcze nie podjęła. Pojawił się trzeci wektor: modele wysokiej klasy, które można uruchamiać lokalnie bez zależności od API dostawcy i bez wysyłania zapytań poza jurysdykcję, lecz których pochodzenie rodzi własny zestaw pytań regulacyjnych, geopolitycznych i strategicznych.
Dla CIO w sektorze regulowanym tworzy to konkretny dylemat, który nie istniał dwa lata temu. Dziś można wdrożyć model klasy frontier w polskim centrum danych, zachować pełną kontrolę operacyjną i prawną nad inferencją, spełnić wymagania retrospektywnej audytowalności, a wszystko to za koszt porównywalny lub niższy od rocznych opłat za najlepszy model amerykański używany przez API. Model pochodzi jednak z chińskiego laboratorium, którego procesy trenowania, dobór danych i nadzór państwowy nie są tak przejrzyste jak u dostawców amerykańskich. To nie pytanie ideologiczne, lecz pytanie o klasy ryzyka, których wcześniej nie trzeba było oceniać. Jaką wagę ma otwartość modelu - możliwość audytu wag, fine-tuningu i izolacji w piwnicy - wobec nieprzejrzystości jego pochodzenia? W części sektorów - przemyśle, zastosowaniach ogólnych i mniej wrażliwych procesach - bilans przechyla się na korzyść modeli chińskich. W innych - obronności, infrastrukturze krytycznej, wybranych segmentach bankowości i sektorze publicznym - pochodzenie pozostaje czerwoną linią, niezależnie od atrakcyjności technicznej. Pominięcie tego trzeciego wektora w strategii AI w 2026 roku jest tym samym, czym było pominięcie chmury publicznej w strategii IT w 2014 roku: można to zrobić, ale za rok wrócisz do tej rozmowy w gorszych okolicznościach.
Gdzie naprawdę potrzebujesz suwerennej AI, a gdzie nie
Dobra wiadomość: suwerenna AI nie musi oznaczać, że wszystko ma być lokalne i „nasze”. Kluczowe jest odróżnienie miejsc, w których wysoki poziom suwerenności jest niezbędny, od tych, gdzie zależność można świadomie zaakceptować.
Można spojrzeć na to jak na prostą macierz:
- pierwsza oś: wrażliwość danych i IP - niska lub wysoka,
- druga oś: krytyczność procesu - niska lub wysoka.
W obszarach, w których dane i IP nie są bardzo wrażliwe, a proces nie jest krytyczny - na przykład w części marketingu i analityki wewnętrznej niskiego ryzyka - korzystanie z globalnych modeli i usług ma sens: liczą się szybkość i koszt. W obszarach, gdzie dane są wysoce wrażliwe - w ochronie zdrowia, finansach i obronności - a proces jest krytyczny, powinna zapalić się czerwona lampka: należy dążyć do tego, aby zarówno dane, jak i inteligencja pozostawały pod kontrolą lokalną. Między tymi skrajnościami leży szeroka strefa pośrednia, w której można stosować podejścia hybrydowe: część komponentów globalna, część lokalna, z jasnym podziałem ról. W tej strefie coraz częściej pojawia się trzecia opcja: model wdrożony lokalnie, lecz pochodzący od dostawcy spoza UE. Jego wybór wymaga odrębnej kalkulacji, w której pochodzenie modelu waży tyle samo co jego klasa techniczna i licencja.
Jak zbudować „wystarczająco suwerenną” AI: trzy warstwy stosu
Zamiast myśleć czarno-biało - „albo wszystko lokalnie, albo wszystko globalnie” - warto zaprojektować modularny stos AI i świadomie zdecydować, które warstwy chcemy kontrolować. W praktyce wdrożeniowej rozwijanej przeze mnie w ramach CDF (Cognitive Deployment Framework) dla sektorów regulowanych suwerenny stos AI można podzielić na trzy warstwy, każdą z odrębnym właścicielem i modelem kontroli.
Warstwa bramy (AI Gateway). Punkt, w którym organizacja komunikuje się z modelami - własnymi lub zewnętrznymi. Odpowiada za kierowanie zapytań do odpowiedniego modelu - lokalnego lub globalnego, zależnie od klasyfikacji danych - wymuszanie polityk dostępu w trybie fail-closed, wykrywanie i maskowanie danych osobowych przed transferem oraz pełny audyt każdej interakcji. Bez tej warstwy każde zapytanie do modelu zewnętrznego jest aktem wiary w dostawcę, a wiara nie jest kategorią, którą można audytować.
Warstwa aplikacyjno-agentowa. Miejsce budowania systemów agentowych, pamięci runtime, semantyki domenowej i orkiestracji. W sektorze regulowanym warstwa ta musi spełniać opisane wyżej wymagania audytowalności: każdy wynik agenta musi dać się retrospektywnie odtworzyć z dokładnością do danych źródłowych, wersji modelu i kontekstu wywołania. To tutaj powstaje rzeczywista przewaga domenowa organizacji i dlatego ta warstwa powinna pozostać u niej.
Warstwa governance i operacji. Tu znajdują się polityki, procesy, audyty, reagowanie na incydenty i cykle życia agentów. W mojej praktyce opisuję ją jako AI-Operating & Working Agreement - umowę ustanawiającą federacyjny model rozliczalności między zespołem centralnym, odpowiedzialnym za platformę, standardy i nadzór, a domenami biznesowymi, odpowiedzialnymi za codzienne działanie agentów w ich przepływach pracy. Bez tej warstwy nawet najlepsza architektura techniczna rozpada się w pierwszym roku użytkowania produkcyjnego, ponieważ gdy coś idzie źle, nikt nie wie, kto za co odpowiada.
Kluczem do sukcesu jest wspólne zaprojektowanie tych trzech warstw, a nie dodawanie ich po fakcie. Suwerenność dołożona jako warstwa compliance do istniejącego stosu nie działa - to jedna z najważniejszych lekcji, jakie wyniosłem z wdrożeń w sektorach regulowanych w ciągu ostatnich dwóch lat.
Co się stanie, jeśli tego nie zrobimy?
Jeśli Europa i europejskie firmy zatrzymają się na poziomie „suwerenności danych”, nie przechodząc do suwerenności warstwy inteligencji, konsekwencje będą bardzo konkretne:
- Branże regulowane nadal będą wahać się przed skalowaniem AI - brak rozwiązań zapewniających pełną kontrolę zablokuje wdrożenia, a produktywność i konkurencyjność pozostaną w tyle za innymi regionami.
- Coraz większa część wartości dodanej będzie powstawać gdzie indziej - tutaj pozostaną koszty infrastruktury i regulacji, podczas gdy zyski z modeli i aplikacji odpłyną.
- Europa i poszczególne państwa staną się przede wszystkim konsumentami technologii, a nie współautorami odpowiedzi na fundamentalne pytania: jak AI powinna działać, jakie wartości odzwierciedlać i jakich standardów etycznych oraz bezpieczeństwa przestrzegać.
Mikrostudium przypadku z praktyki
Najszybszym testem rzeczywistej suwerenności AI nie jest pytanie o lokalizację serwera. Jest nim pytanie: czy potrafisz dokładnie odtworzyć, jakich danych i której wersji modelu użyto do podjęcia konkretnej decyzji trzy miesiące temu? Z dokładnością do rekordu, wersji wag i kontekstu wywołania. Jeśli tak, masz suwerenność jako zdolność operacyjną. Jeśli nie, masz ją jako deklarację w polityce cyfrowej. Większość organizacji mówiących dziś o suwerenności AI nie zdałaby tego testu. To pierwsze pytanie, które warto zadać przed jakąkolwiek inwestycją w stos, ponieważ bez tej zdolności żadna inna warstwa kontroli nie ma znaczenia.
W następnym artykule pokażę, jak przełożyć tę diagnozę na praktyczną mapę drogową: jakie scenariusze stoją przed Europą do 2030 roku, które warstwy stosu warto realistycznie kontrolować i jak zbudować „wystarczająco suwerenny” ekosystem bez popadania w izolacjonizm.
Ten cykl rozkłada transformację AI w sektorach regulowanych na siedem warstw
- Infrastruktura fizyczna - AI pochłania energię elektryczną i światłowody.
- Modernizacja systemów legacy - systemy legacy nie umrą same.
- Fundament danych - agenci AI potykają się o dane.
- Suwerenność: diagnoza - masz suwerenność danych, ale nie masz suwerennej AI; właśnie to czytasz.
- Suwerenność: praktyka - suwerenna AI w praktyce.
- Interfejs człowiek-system - od chatbota do współpracownika.
- Zaufanie i przywództwo - zaufanie jako waluta skalowania AI.
Cały cykl jest zapisem tego, czego nauczyłem się podczas pracy w sektorach regulowanych: decyzji, które trzeba było podejmować szybciej, niż pozwalała ostrożność, błędów, które nauczyły mnie więcej niż sukcesy, intuicji wyostrzonej w rozmowach bez scenariusza i woli zbudowania czegoś, co jeszcze nie istnieje.